
存储机制
智能合约中的状态变量的值都是永久存储在链上的,这些值存储在一个叫做存储槽的地方。每个智能合约中都有 个存储槽,如下图所示:
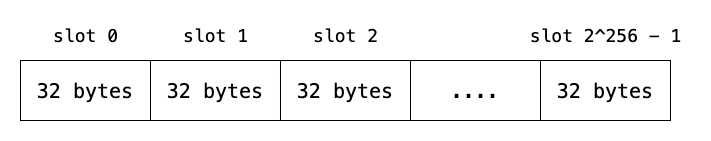
这些存储槽实际上并没有占据这么大的空间,而是需要用到的时候才会去分配。
知道了存储槽的概念,那么EVM又是如何去分配这些空间的呢,这就需要根据数据类型来讨论
存储分配
定长类型
Solidity 中有很多固定长度的数据类型,例如 uint8、uint16、uint256等,又或者 bytes2、bytes32等。uint256 和 bytes32 存储的值都是 32 个字节,刚好占据一个存储槽。而 uint8 占据的空间只有 1 个字节。
假设在合约中按顺序定义了以下的变量:
uint256 public a;
uint256 public b;
bytes32 public c;由于变量 a、b、c 的值都是 32 个字节,所以分别占据了存储槽 slot 0、slot 1、slot 2
注意:分配的存储槽是按照变量在合约中顺序分配的。
通过 ethers.js 读取存储槽的值
const { ethers } = require('ethers')
const provider = new ethers.providers.JsonRpcProvider()

const getSlotValue = async () => {
  // 读取 contractAddress 合约中 slot 1的值
  const v = await provider.getStorageAt(contractAddress, 1)
}如果定义的变量不足 32 个字节,其值又是如何分配的呢
假设定义了如下变量
uint8 public a;
bytes2 public b;
uint256 public c;a 占据了 1 个字节,b 占据了 2 个字节。由于 a 和 b 加起来所占用的字节数不足 32,所以都会被存储在 slot 0, 而 c 占据了 32 个字节,由于 slot 0 只剩下 29 个字节的可用空间了,所以 c 需要占用一个单独的存储槽 slot 1。
而对于定长数组的空间分配也一样,可以看成定义了数组长度个类型的变量
uint[5] arr = [1, 2, 3, 4, 5]可以看成定义了 5 个 uint256 类型的变量,由于 uint256 占据了 32 个字节的空间,所以该数组的每个元素占据的空间都是 32 字节,也正好是一个存储槽的空间, 所以该定长数组 arr 占据了 5 个存储槽,类似的,如果是 uint16[5],由于 uint16 占据了 2 个字节,数组总占据的空间就是 10 个字节,所以数组只会占据一个存储槽。
结构体的内存分配也是按照同样的规则,如下面的代码
struct User{
  uint age;
  bool isMale;
}
User public user;对变量 user 的空间分配,就是对变量所对应的结构体内部变量进行的分配,相当于定义了变量
uint user.agebool user.isMale
user.age 占据了 32 个字节的空间,被分配到 slot 0, user.isMale 被分配到了 slot 1
如果结构体内部定义了非定长的数据类型,如
struct User {
  string name;
  uint age;
  uint[] score;
}存储槽又该如何分配呢?
非定长类型
由于非定长类型的大小未知,无法在编译期间确定其存储。因此 Solidity 在编译动态数组、映射类型、字符串时采用的是特定算法
动态数组
动态数组由两部分组成,数组的长度和元素值,在定义了动态数组后,将在本该存储数组值的存储槽存储元素数量(单独占用一个存储槽),元素的值的存储起始槽则在 keccak256(slot)
uint[] public arr = [1, 2, 3, 4, 5];数组 arr 中有 5 个元素,则在 slot 0 中存储数字 5。其次元素值的存储起始位置需要通过计算得到
keccak256(0) = 0x290decd9548b62a8d60345a988386fc84ba6bc95484008f6362f93160ef3e563
计算得到了起始位置后,值将按序存储。
字符串类型
字符串 string 和 bytes 实际是一个特殊的数组,编译器对这类数据有进行优化。如果 string 和 bytes 的数据很短。那么它们的长度也会和数据一起存储到同一个插槽。 具体为:
-
如果数据长度小于等于 31 字节, 则它存储在高位字节(左对齐),最低位字节存储
length * 2。 -
如果数据长度超出 31 字节,则在主插槽存储
length * 2 + 1, 数据照常存储在keccak256(slot)中。
例如:
string public short = 'hello'
string public long = 'State variables of contracts are stored in storage in a compact way such that multiple values sometimes use the same storage slot'由于变量 short 的内容很短,所以其值和长度被存储在 slot 0
变量 long 的内容很长,所以其长度存储在 slot 1 , 内容存储在 keccak256(1) 中。
映射类型
mapping 类型是一个 key-value 结构,其所在的存储槽会空置,并且其值存储位置根据 keccak(key + slot) 计算得到。
如下代码
contract Storage {
  uint public a = 100;
  mapping(uint => bool) public b;
  uint public c = 11;

  constructor() public {
    b[100] = true;
  }
}-
变量
a占据slot 0 -
变量
b占据slot 1, 但却是空置的。可以理解为slot 1是虚拟的,并不实际存在。作用就是用来计算value的存储位置 -
变量
c占据slot 2
已知变量 b 的 slot 是 1, 就可以根据公式 keccak256(key + slot) 轻松计算出key 为 10 时值的存储位置:
keccak256(abi.encode(10, 1))